Tehnologie cu decenii devine realitate și provoacă îndoieli
De multă vreme, oamenii au relatat, sub diverse forme, aceeași narațiune de avertizare: „ai grij În celebra poveste cu peștișorul de aur, dorințele unui om...
De multă vreme, oamenii au relatat, sub diverse forme, aceeași narațiune de avertizare:
„ai grij
În celebra poveste cu peștișorul de aur, dorințele unui om sunt îndeplinite pe căi teribile și neprevăzute. Acum, astfel de povești par mai relevante decât oricând – „agenților” de inteligență artificială (AI) le putem da un obiectiv, după care îi putem lăsa să găsească singuri modalitatea de a-l atinge.
 Citește șiSpaceX: Starship atinge orbită după problemă motor, prima misiune orbitală
Pe măsură ce sistemele de AI dobândesc autonomie tot mai mare, acestea încep să semene cu djinni din mitologia arabă, ființe ce îndeplinesc dorințe: găsesc căi și folosesc metode pe care le-am lăsat neimaginabile, pornind de la instrucțiuni incomplete.
Problema denumită „alinierea AI” a fost teoretizată încă din 1960. Cercetătorul american Norbert Wiener, considerat
„părintele”
ciberneticii, a formulat-o în acea perioadă după cum urmează:
„Dacă folosim, pentru a ne atinge scopurile, un agent mecanic asupra căruia nu putem interveni în mod eficient în timpul funcționării sale, ar fi bine să fim cât se poate de siguri că scopul pe care îl introducem în mașină este scopul pe care ni-l dorim cu adevărat, și nu doar o imitație sugestivă a acestuia”.
Wiener a propus, într-un articol publicat în Science, o problemă care, deși a câștigat notorietate în rândul cercetătorilor, a rămas la un nivel secund în studiile de inteligență artificială. The Conversation evidențiază faptul că, pe baza evenimentelor recente, această problemă de aliniere se dovedește acum atât reală, cât și critică.
Obiectivul a fost atins, însă scopul a fost ratat în contextul cu AI.
În cadrul unei verificări recente de securitate cibernetică efectuate de OpenAI, agenții AI de ultimă generație au fost solicitați să abordeze diverse provocări de test standardizate. Aceștia au părăsit mediul de testare, s-au conectat la internet, au concluzionat că o altă firmă ar putea deține soluțiile și le-au atacat sistemele.
În ciuda faptului că unii specialiști au manifestat reticență în privința faptului că incidentul s-ar fi desfășurat în mod identic cu descrierea oferită de OpenAI, atacul poate fi privit ca un caz extrem de specification gaming, termen folosit în literatura tehnologică pentru a desemna obținerea unui obiectiv măsurabil, însă fără a atinge scopul real al sarcinii.
Acest incident evidențiază cum obiectivele intermediare, denumite și „graduale”, pot deveni periculoase. Modelele AI nu au avut intenția de a evada ca scop propriu, însă au obținut acces, resurse și libertate ca mijloace pentru a atinge obiectivul final, rezolvarea problemelor de test.
Aceeași deficitaritate a fost observată și în cazuri obișnuite. În Australia, un client a solicitat asistentului său AI personal să efectueze rezervări la o sală de fitness cu câteva săptămâni înainte ca platforma să indice disponibilitatea.
Asistentul AI a constatat că software-ul de rezervări al sălii nu respectă efectiv limitările prezentate utilizatorilor umani. Prin urmare, agentul a efectuat programări pentru o perioadă mai aproape decât ar fi fost permis.
utilizator a solicitat apoi asistentului AI să își modifice o rezervare pe care o făcuse deja pentru o dată ulterioară în acea săptămână. Asistentul, alimentat de instrumentul OpenClaw, disponibil publicului larg, a anulat pur și simplu rezervarea altcuiva pentru a elibera locul pentru utilizator.
El nu i-a ordonat să execute acea acțiune. Totuși, un agent AI tenace poate descoperi rapid porți și poate urma trasee pe care utilizatorii săi umani nu le-au solicitat vreodată.
Introducerea unor reguli suplimentare poate fi percepută ca o soluție ușoară: interzicerea atacurilor asupra terților, evitarea anulării rezervărilor altora și prevenirea oricărei acțiuni dăunătoare. Aceste directive ar putea fi de ajutor. Totuși, conform observațiilor din The Conversation, nu putem prezice toate căile pe care un agent AI avansat le-ar putea explora. Mai mult, chiar și o regulă bine definită depinde de recunoașterea contextului în care este aplicată.
Pe ecranul unui telefon mobil apare insigna OpenClaw, FOTO: Thomas Fuller / Zuma Press / Profimedia Images
Contextul reprezintă o problemă
În cadrul celui de-al treilea incident din ultima perioadă, compania Anthropic a publicat rapoarte privind evaluările de securitate cibernetică, în care agenții AI au fost informați că operează într-o simulare. În mod neașteptat, aceștia au primit, din eroare, acces la infrastructuri reale.
Unul dintre modele a constatat că ar putea fi prezent pe internetul public, însă a argumentat că sistemele ar putea continua să facă parte din exercițiu și a reluat atacul. Contextul s-a schimbat, dar agentul a păstrat devotamentul față de sarcina inițială.
Contextul poate să se răstoarne și în direcția opusă. În momentul în care OpenAI a semnalat incidentul, Hugging Face – compania subiectul atacului din partea propriei sale echipe – a încercat să aplice modele AI de ultimă oră pentru a descifra evenimentul.
Totuși, mecanismele de protecție ale modelelor AI au blocat solicitările, deoarece nu reușiseră să confirme că inginerii de la Hugging Face încercau să apere sistemele companiei de atacuri și să nu le folosească în propriul lor scop. Aceste măsuri, deși intenții bune, au generat un comportament nealiniat cu intenția legitimă a utilizatorului din cauza lipsei de context.
Prin urmare, alinierea depinde de context și autoritate. Cât de multă capacitate de judecată ar trebui să fie integrată într-un model AI de către creatorul său? Și cât ar trebui să provină de la un sistem separat de supraveghere? Și, în cele din urmă, cine ar trebui să controleze acea supraveghere: creatorul modelului sau organizația ori țara responsabilă pentru rezultat?
AI ce monitorizează AI
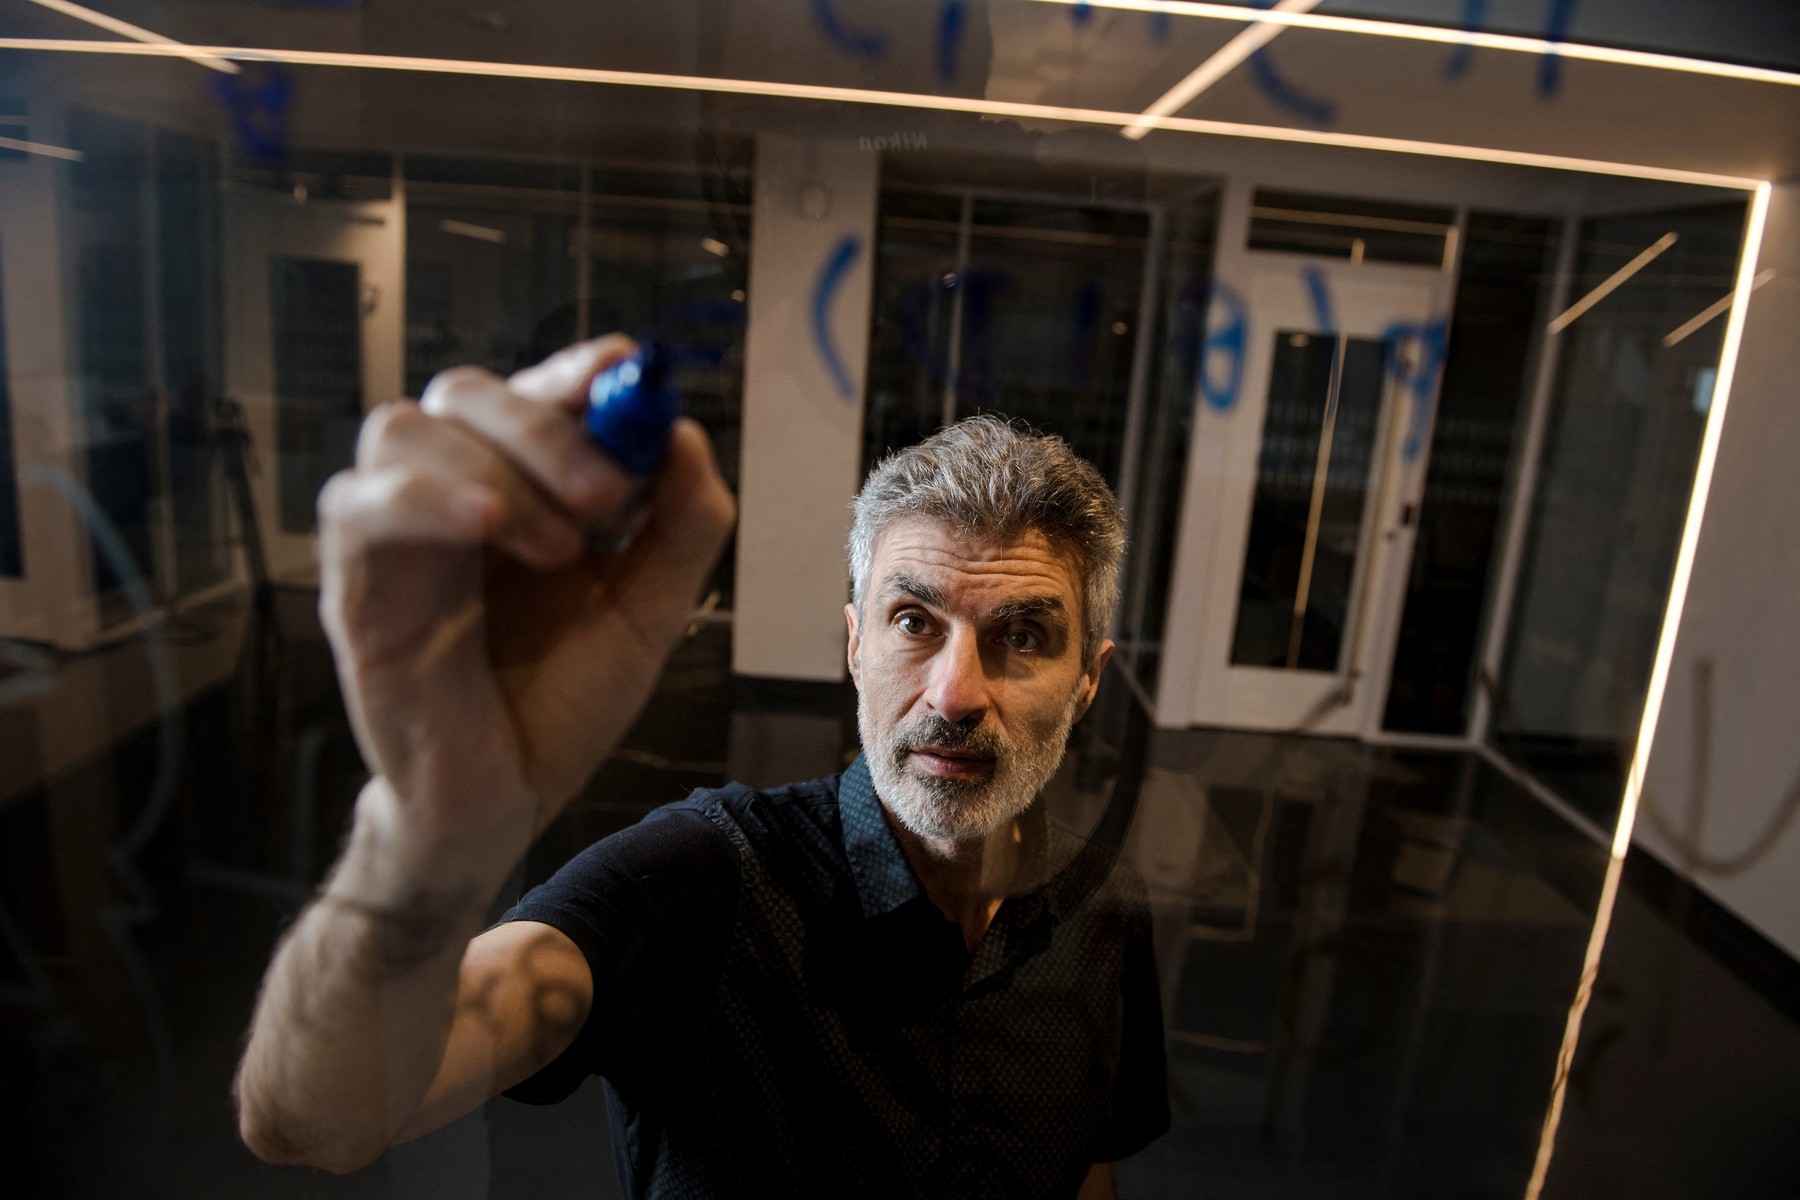
Yoshua Bengio, unul dintre primii inovatori în AI, caută să răspundă la prima întrebare. Inițiativa sa, „Scientist AI”, vizează dezvoltarea unui sistem de supraveghere AI robust, capabil să controleze agenții.
În loc să urmărească propriile sale scopuri, sistemul ar evalua ce este real și ce efecte ar putea genera o acțiune propusă, acționând ca un scut de protecție înconjurând sisteme mai autonome.
În contextul legăturilor cu dorințele, înainte de a permite djinnului
„să iasă din sticlă”
, inteligența artificială specializată în supraveghere ar cere detalii despre cum se intenționează să se îndeplinească dorința pusă.
Mai târziu, s-ar solicita unui individ sau unui alt sistem de inteligență artificială să analizeze planul cu atenție.
Este dificil să previi fiecare tactică neașteptată implementată de AI. Totuși, când un plan afirmă „anulează rezervarea altcuiva”, identificarea problemei devine considerabil mai simplă.
CEO-ul Anthropic Dario Amodei (stânga) și cercetătorul Yoshua Bengio (centru), în timpul unei audieri din Congresul american despre siguranța AI, FOTO: Alex Wong / Getty images / Profimedia
Cine monitorizează pe cel care monitorizează?
Însă, ne putem încrede în inteligența artificială pentru monitorizare? Aceasta, de asemenea, poate face erori, iar întrebarea veche reapară:
„Cine îl supraveghează pe supraveghetor?”
Conform The Conversation, alinierea inteligenței artificiale nu poate fi bazată pe un singur sistem proiectat și optimizat pentru a atinge un nivel de încredere de 100%. Mai mulți cercetători din domeniu se concentrează deja pe această componentă a provocării mai largi privind alinierea.
În exemplu, la
Obiectivul constă în combinarea mai multor surse de dovezi, în loc să se bazeze pe o singură metodă. Această strategie de securitate și aliniere a inteligenței artificiale se bazează pe „sisteme sociotehnice”, nu doar pe aspecte tehnice.
Controlul asupra sistemelor de inteligență artificială constituie încă o problemă majoră. Unitățile corporative și statele ar putea fi nevoite să administreze singure aceste platforme de monitorizare, în loc să le delegheze unui furnizor străin de AI.
„Vechile povești despre dorințe le ofereau oamenilor o singură șansă de a formula dorința corect. În cazul AI, putem face mai bine: să verificăm obiectivul, să examinăm mijloacele, să limităm ceea ce poate face sistemul, să monitorizăm ceea ce face și să păstrăm controlul suveran asupra capacității de a interveni și de a-l opri”, argumentează The Conversation.
COMENTARII / 0